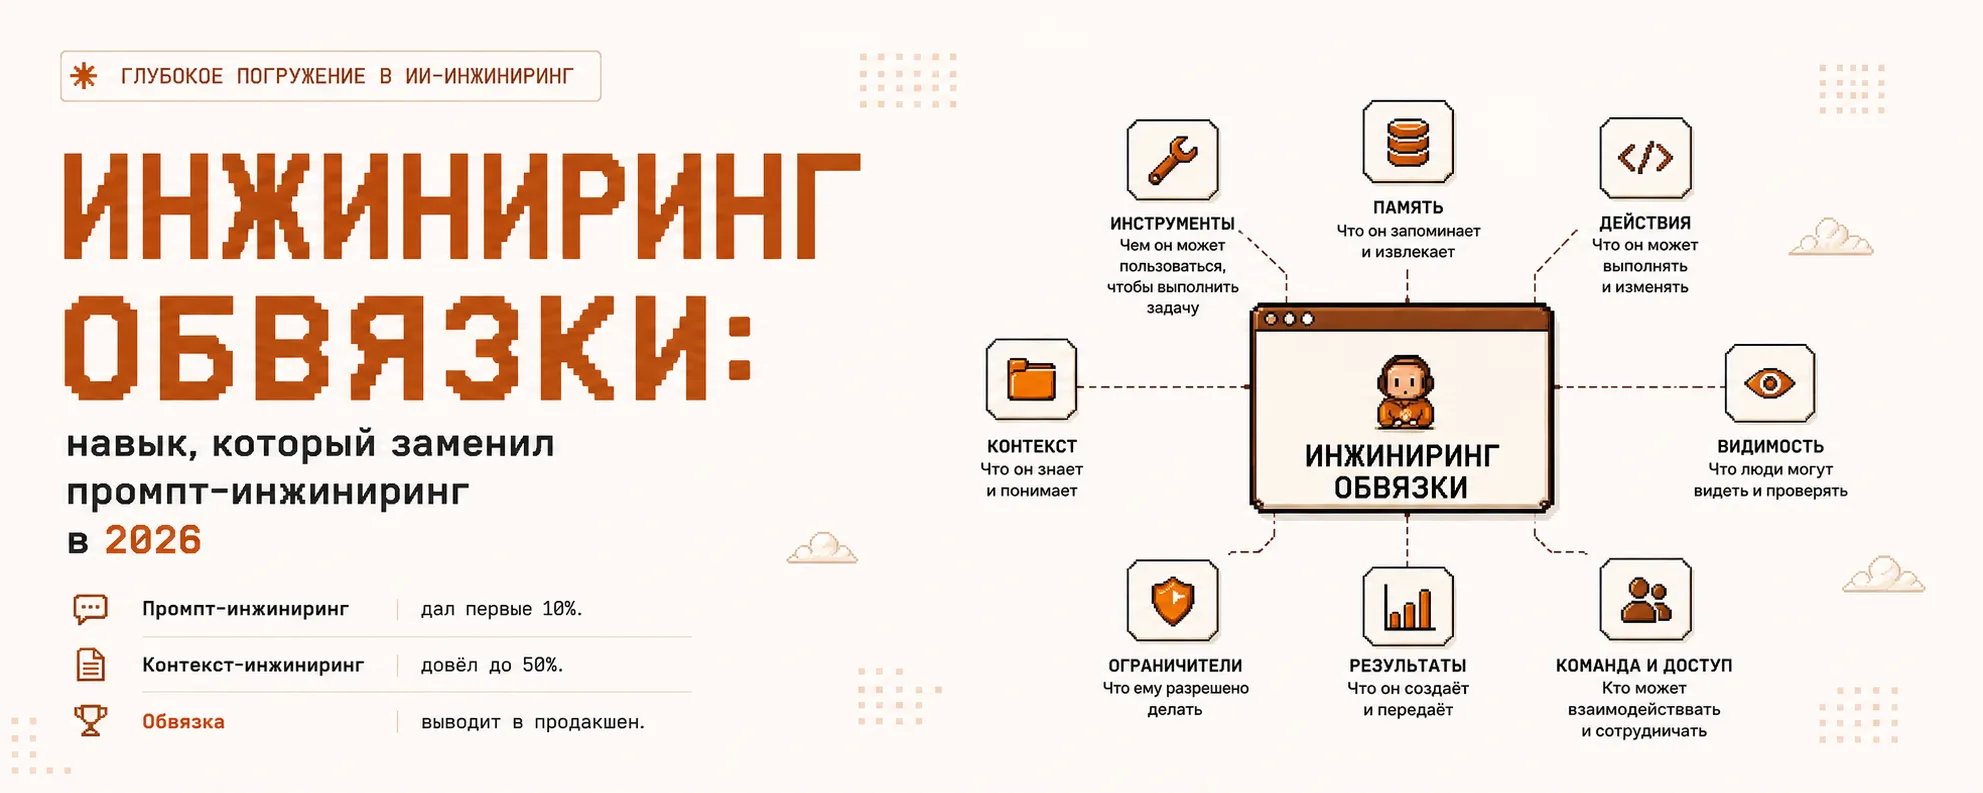
В 2024 году главным навыком было писать более качественные промпты. В 2025-м — подавать модели более качественный контекст. В 2026-м ни то ни другое уже не является узким местом.
Узкое место — всё, что окружает модель: кто предоставляет ей инструменты, кто проверяет её работу, что она запоминает, к чему ей разрешено прикасаться и может ли кто-нибудь увидеть, что она сделала. Теперь у этого уровня есть название. Это обвязка.
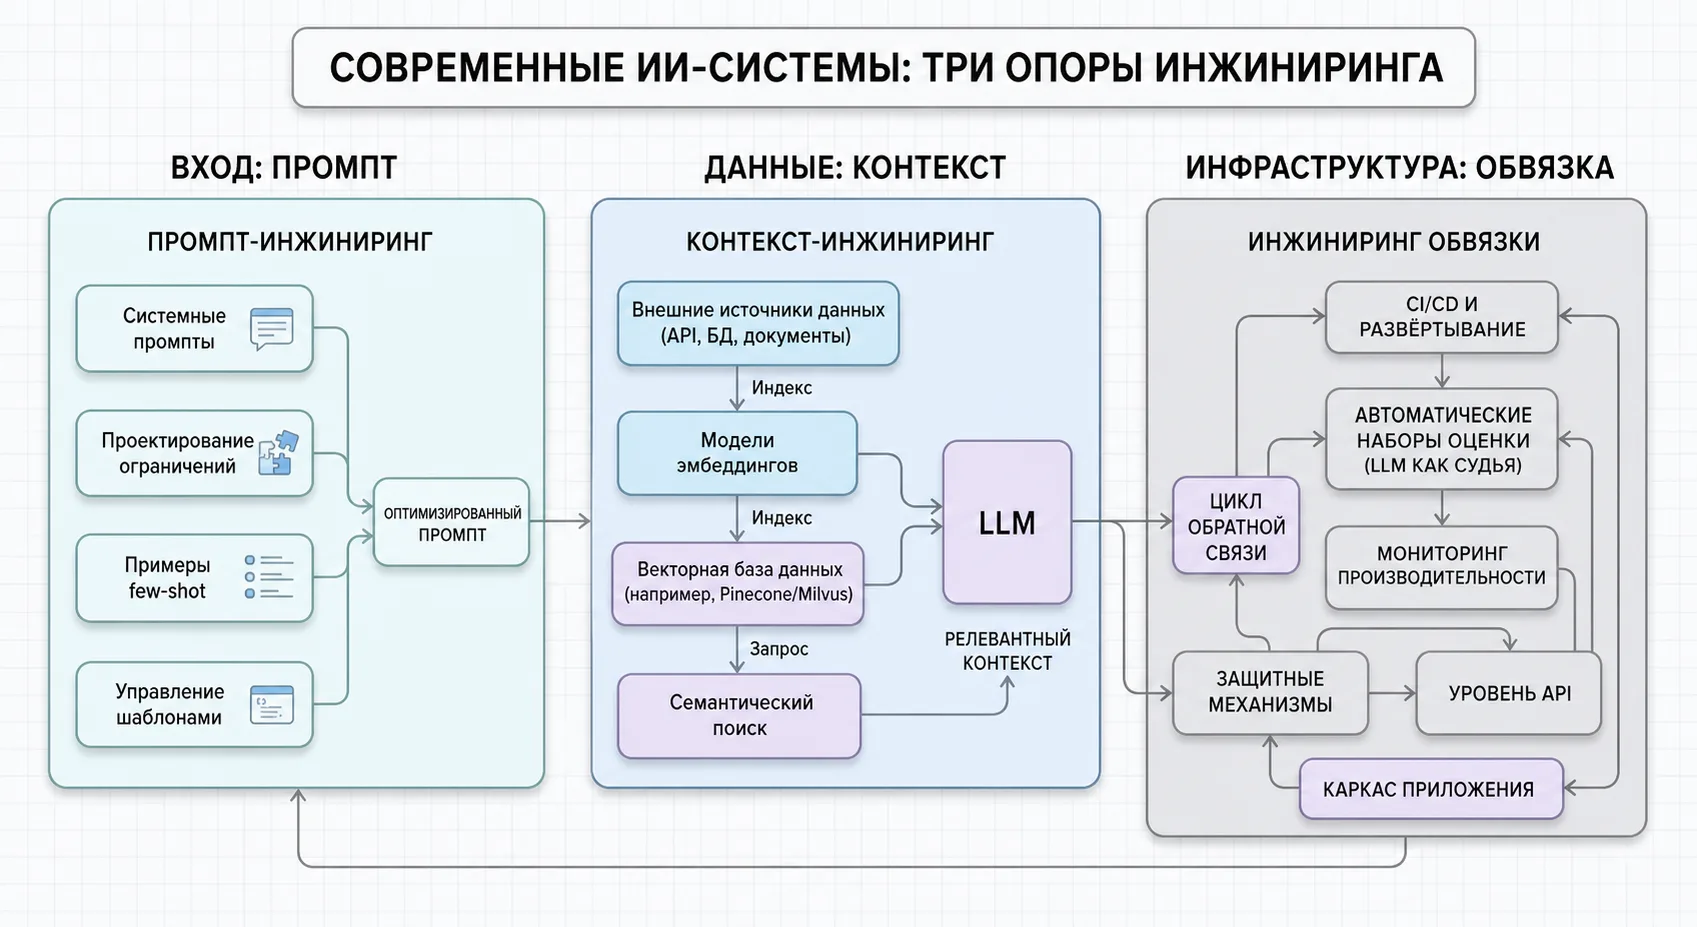
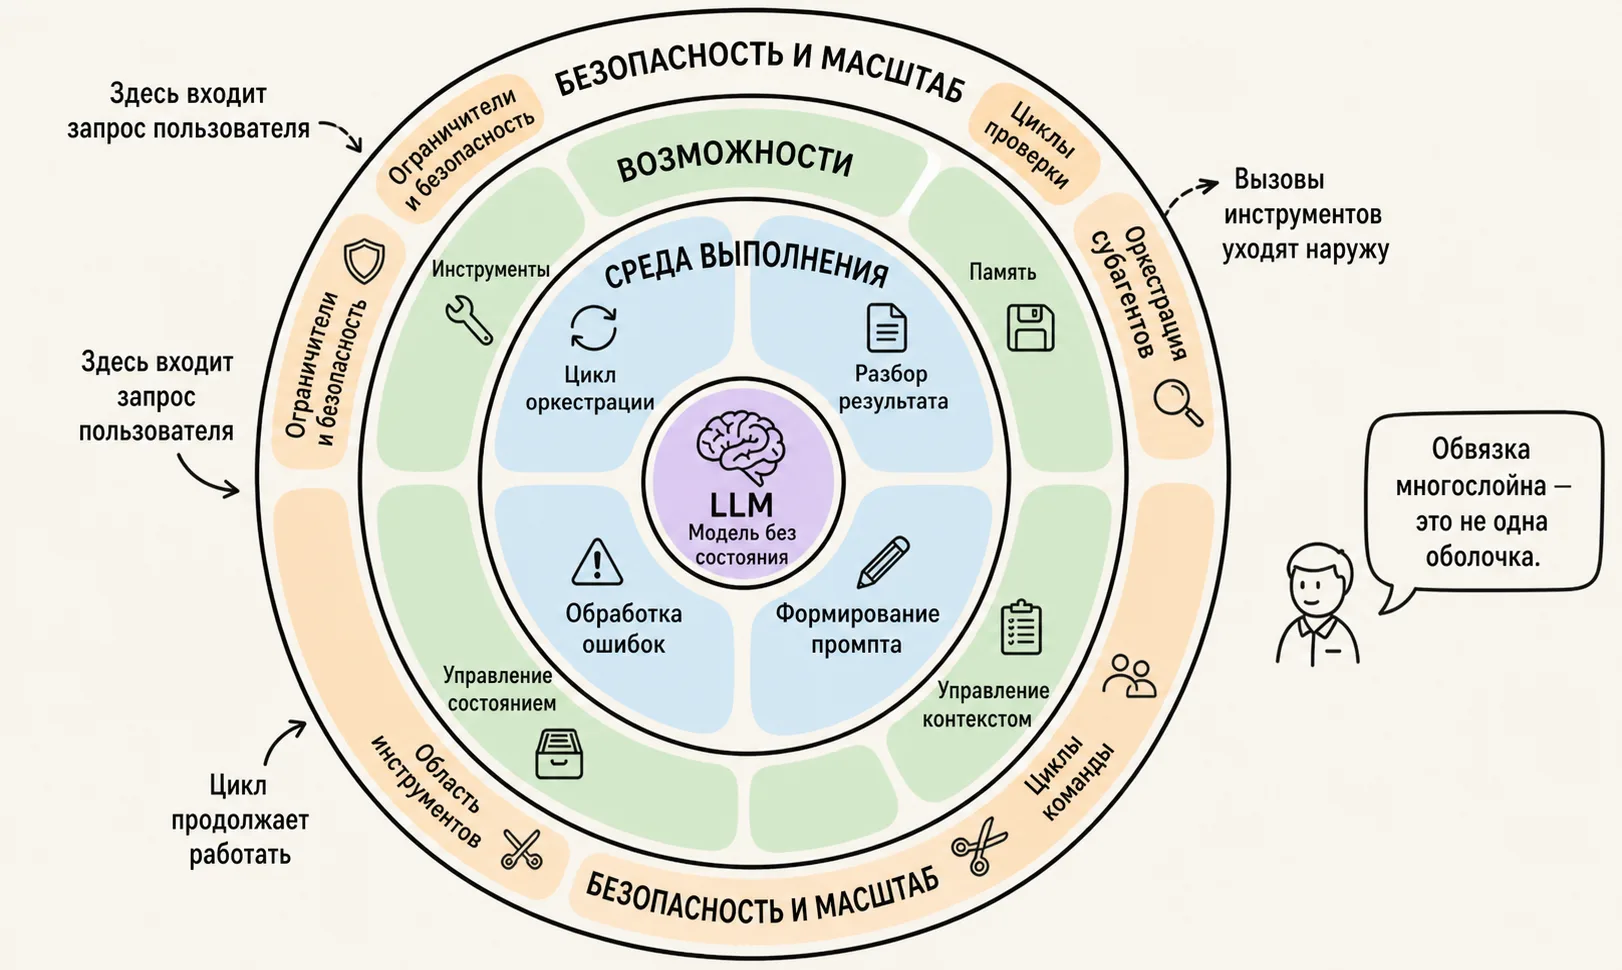
Каждая новая волна не заменяла предыдущую, а поглощала её. Контекст-инжиниринг вобрал в себя промпт-инжиниринг: то, что вы даёте модели, важнее формулировки вопроса. Инжиниринг обвязки поглощает оба подхода: обвязка решает, какой контекст загрузить и какой промпт отправить, а затем добавляет семь вещей, которые не могут обеспечить ни промпты, ни контекст по отдельности: управление инструментами, проверку, память, права доступа, наблюдаемость, маршрутизацию и обратную связь.
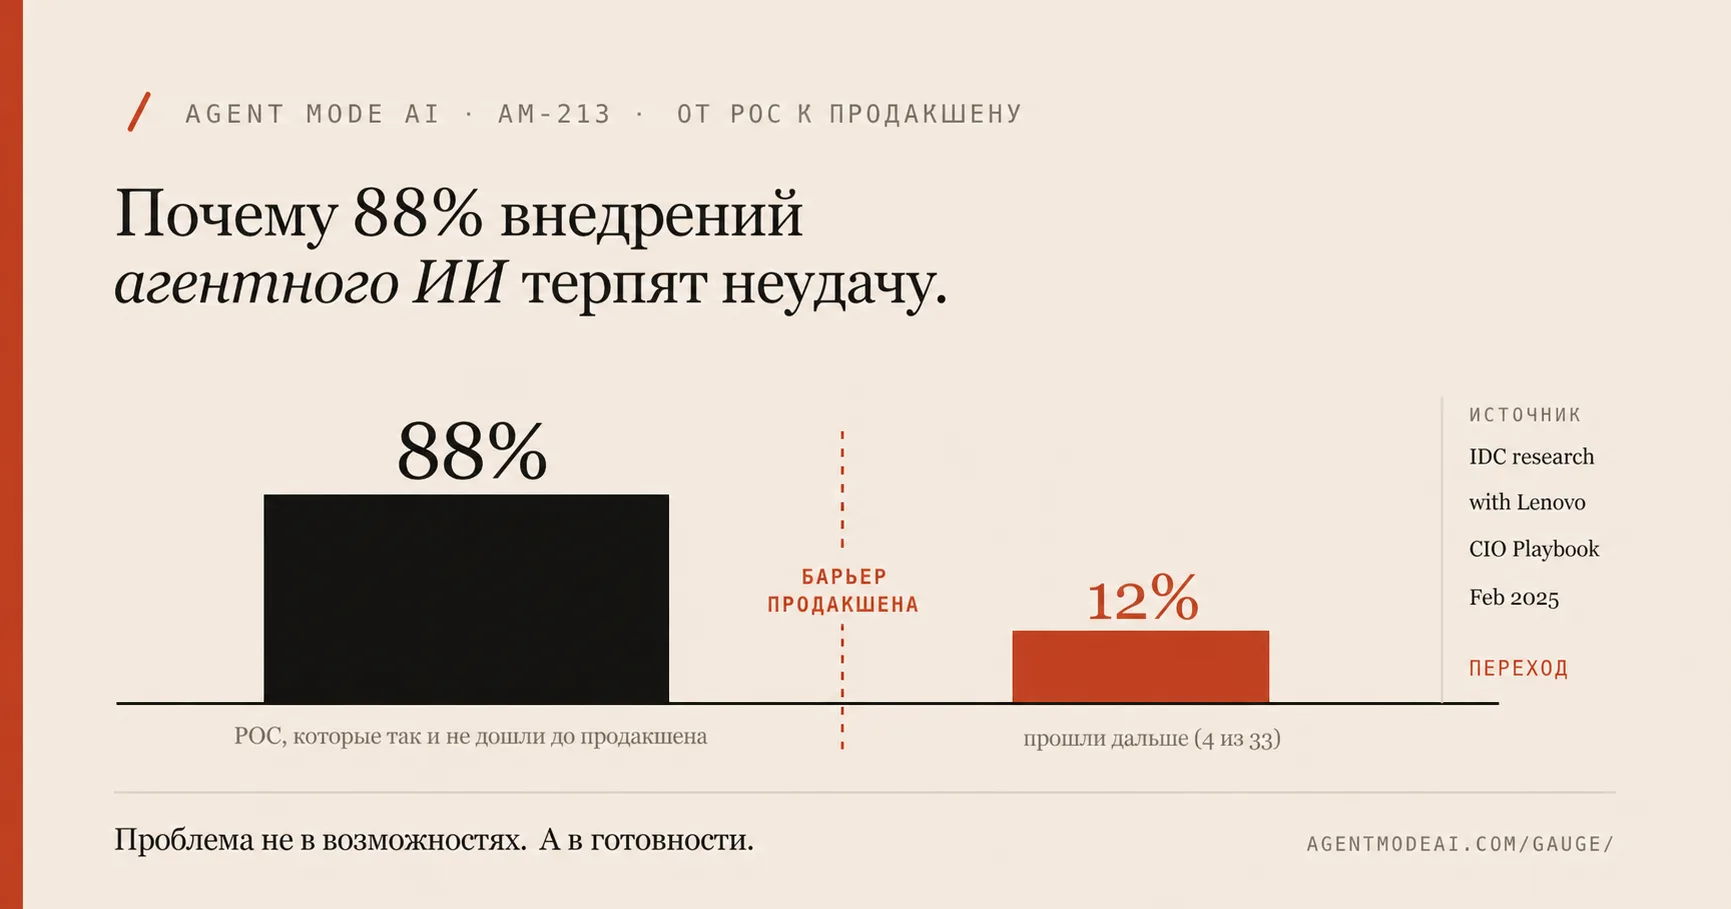
88% корпоративных проектов с ИИ-агентами так и не доходят до продакшена. Причина почти никогда не в модели. Проекты губят деградация контекста, отсутствие защитных механизмов, непостоянное состояние или циклы обратной связи, которые так и не замыкаются. Две команды, использующие одну и ту же модель, но разные обвязки, получают радикально разные результаты. Отличие создаёт обвязка, а не модель.
Что такое обвязка на самом деле
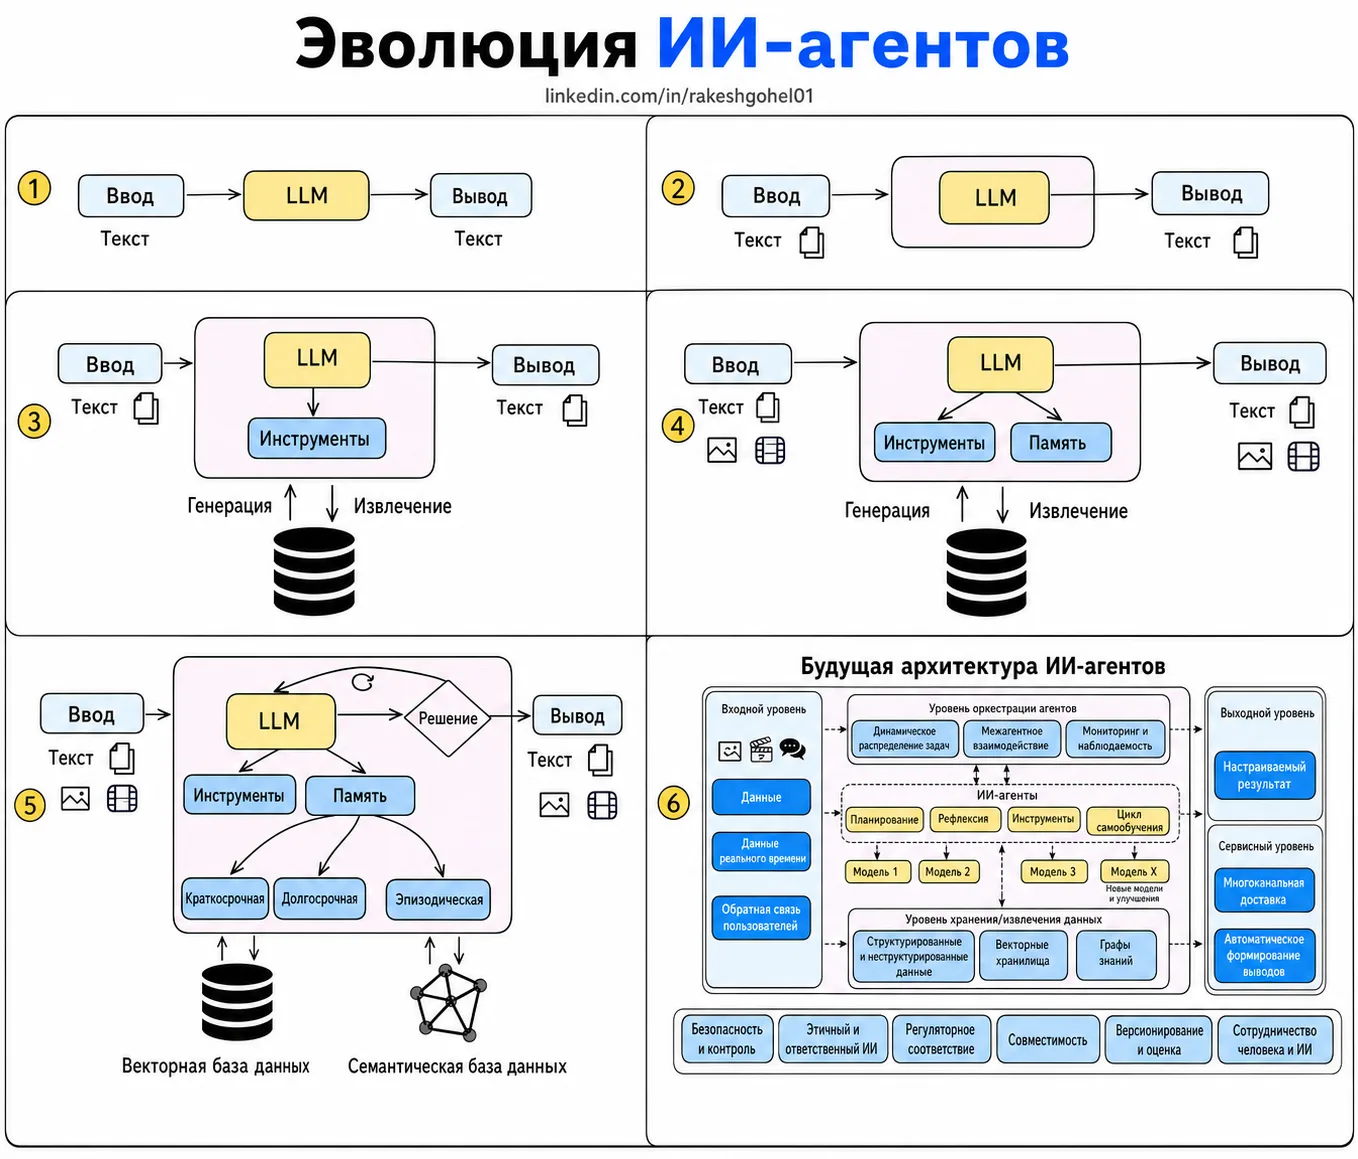
В модели заключён исходный интеллект. Обвязка делает этот интеллект надёжным. Это исполнительный уровень между моделью и реальным миром: диспетчеризация инструментов, проверка, память, права доступа и журналирование.
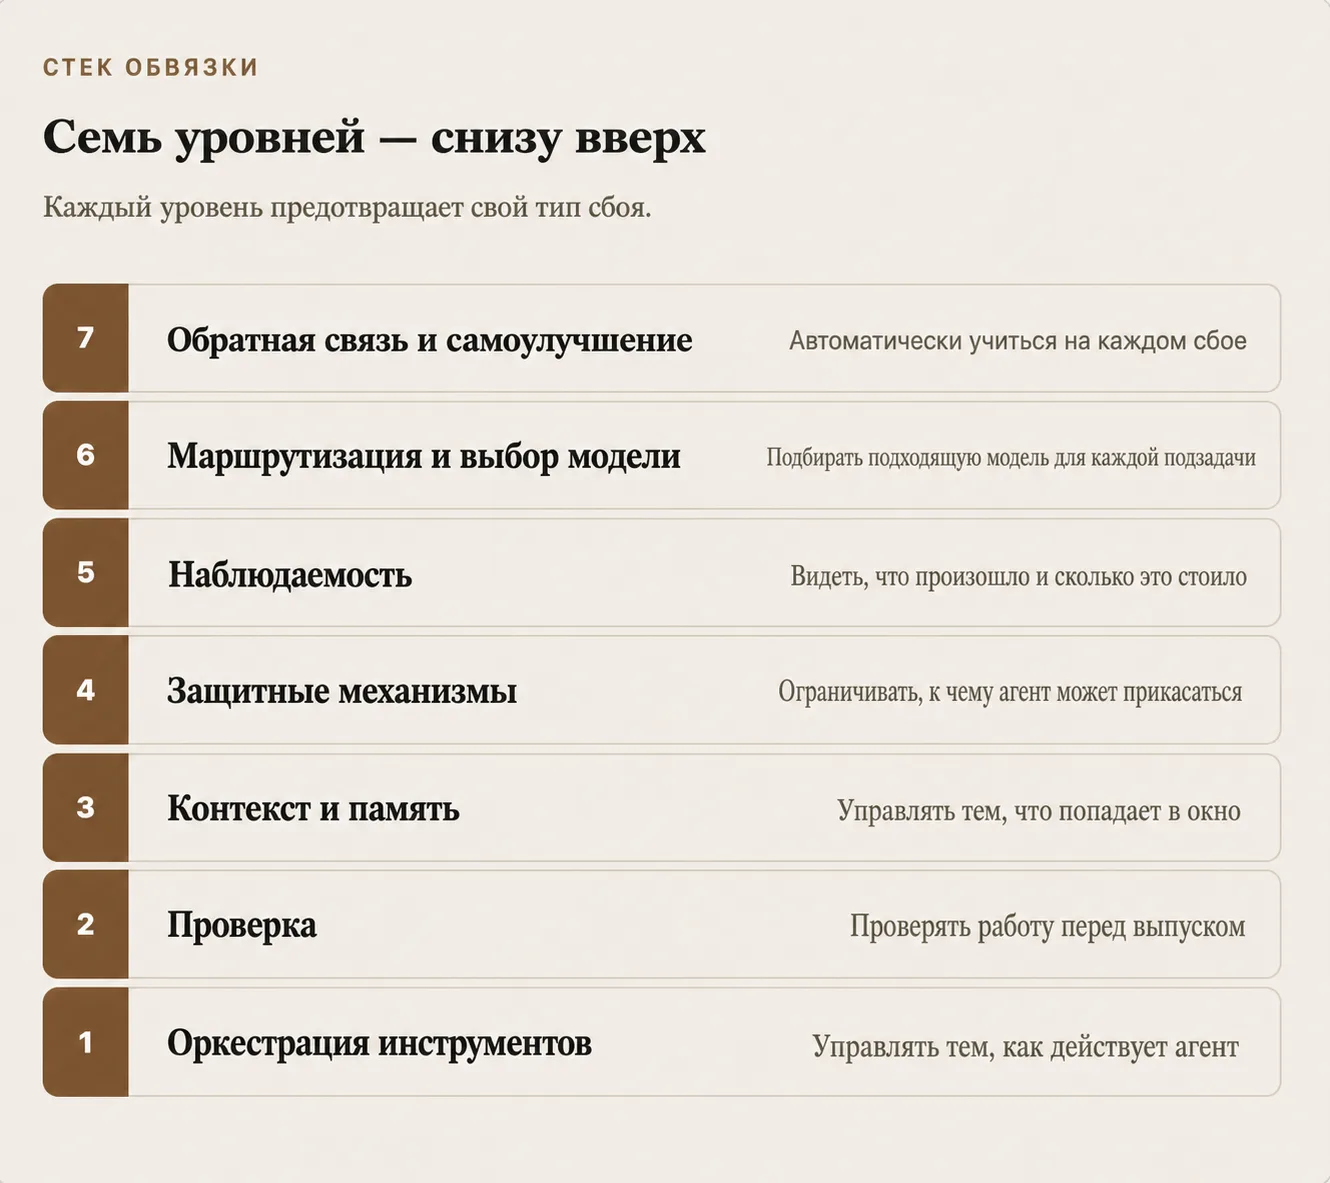
Продакшен-обвязка состоит из семи уровней. Каждый из них предотвращает отдельный класс сбоев.
1. Оркестрация инструментов
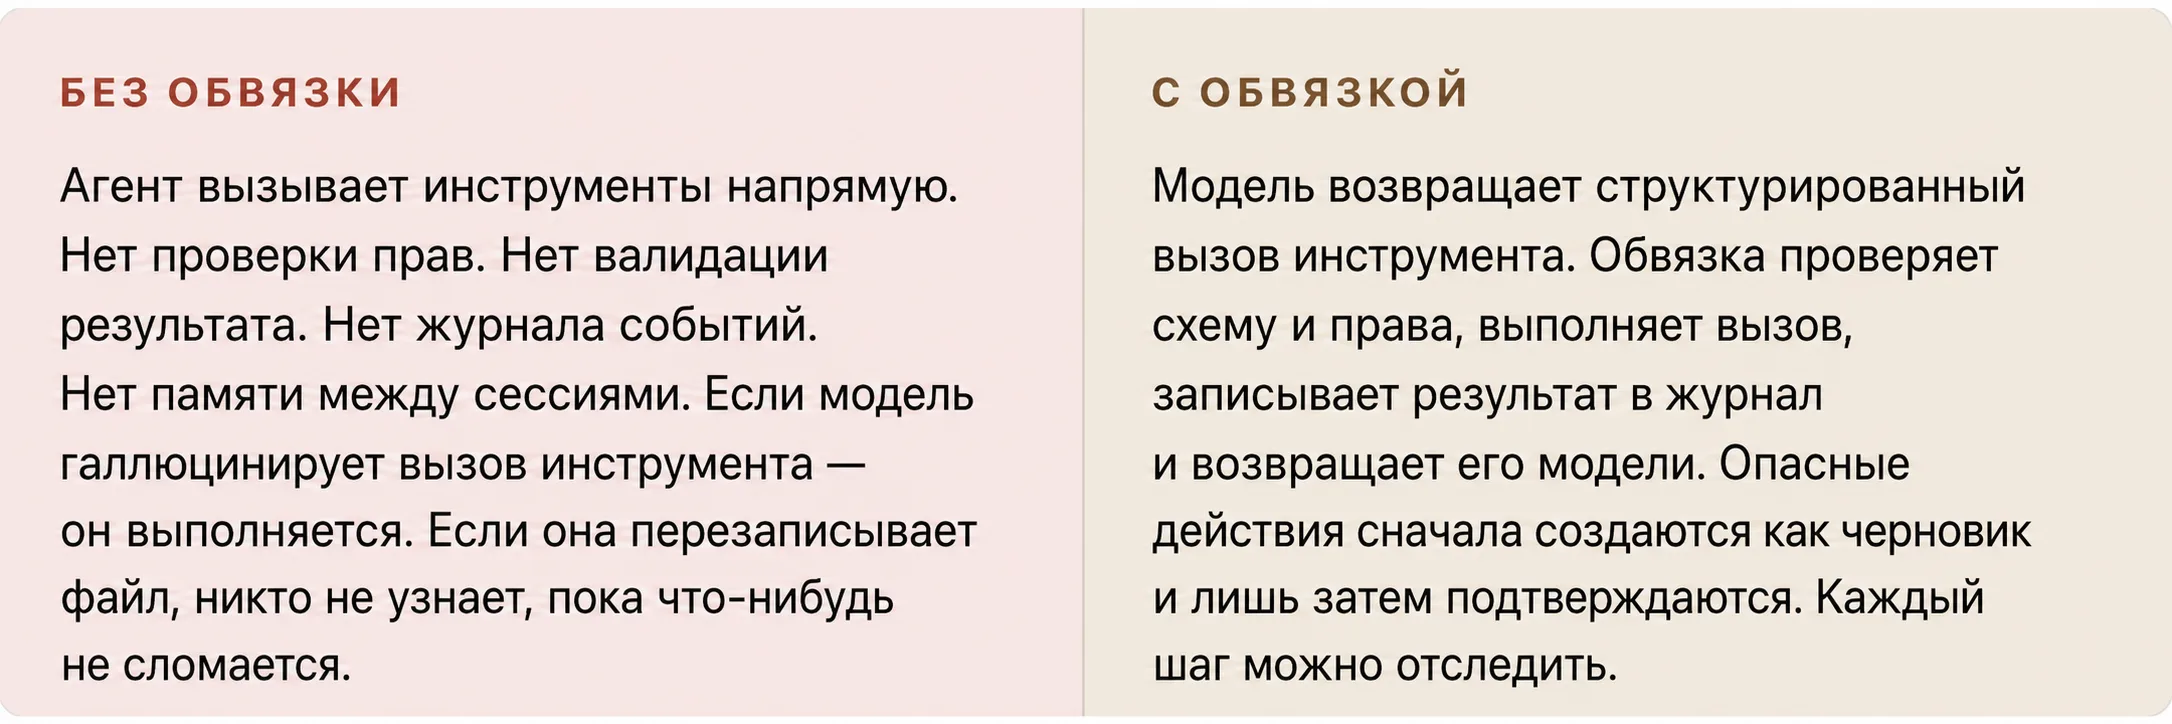
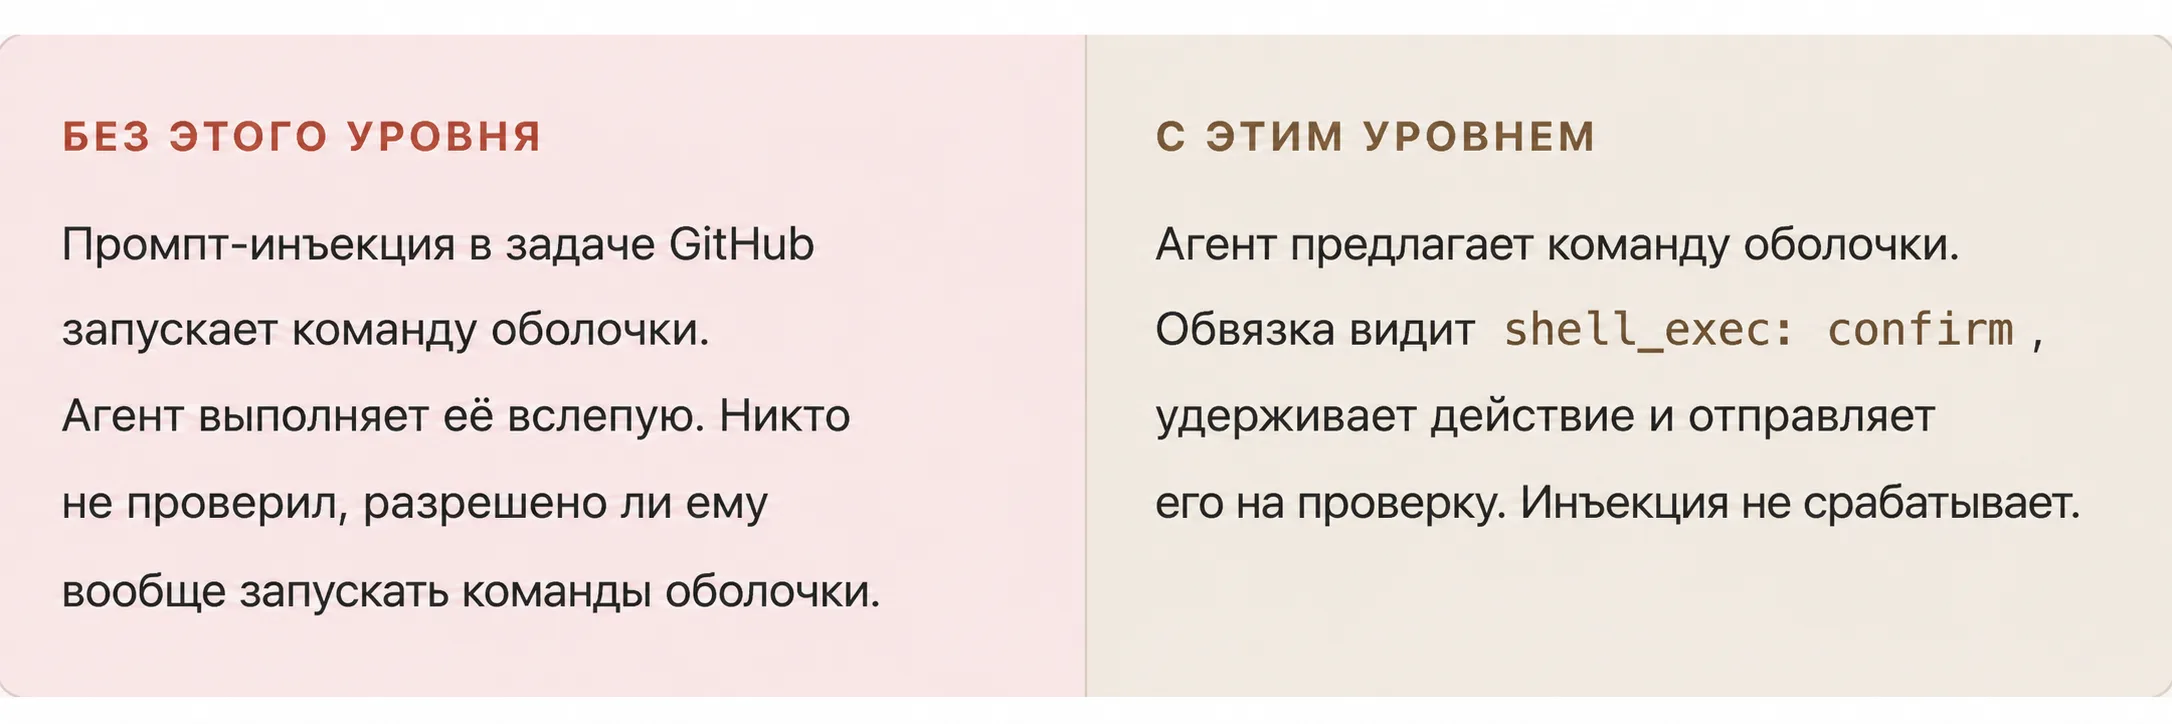
Самое важное правило: никогда не позволяйте модели вызывать инструменты напрямую. Модель возвращает структурированный вызов инструмента — имя функции и аргументы. Обвязка проверяет схему и права доступа, выполняет вызов и возвращает результат модели. Это не даёт промпт-инъекции перерасти в выполнение произвольного кода.
Это паттерн «черновик — подтверждение». Опасные действия сначала оформляются как черновик и лишь затем явно подтверждаются. Модель предлагает: «Удалить этот файл». Обвязка удерживает действие и запрашивает подтверждение. Операции только для чтения выполняются сразу. Операции записи ждут разрешения.
tools:
  file_read: auto        # подтверждение не требуется
  file_write: auto       # безопасно, с версионированием
  file_delete: confirm   # требуется подтверждение человека
  git_commit: auto
  git_push: confirm      # необратимое действие
  shell_exec: confirm    # произвольное выполнение — всегда удерживать
  api_call: auto         # конечные точки только для чтения
  api_mutate: confirm    # конечные точки, изменяющие состояние
Будь то успешный ответ API, отказ в доступе или тайм-аут, агент всегда получает обратно структурированное наблюдение. Никаких зависших обещаний. Никаких молчаливых сбоев. Обвязка превращает каждое взаимодействие с инструментом в понятный цикл «запрос — ответ», о котором агент может рассуждать, вместо того чтобы разбирать сырой вывод командной оболочки и гадать, что произошло.
2. Циклы проверки
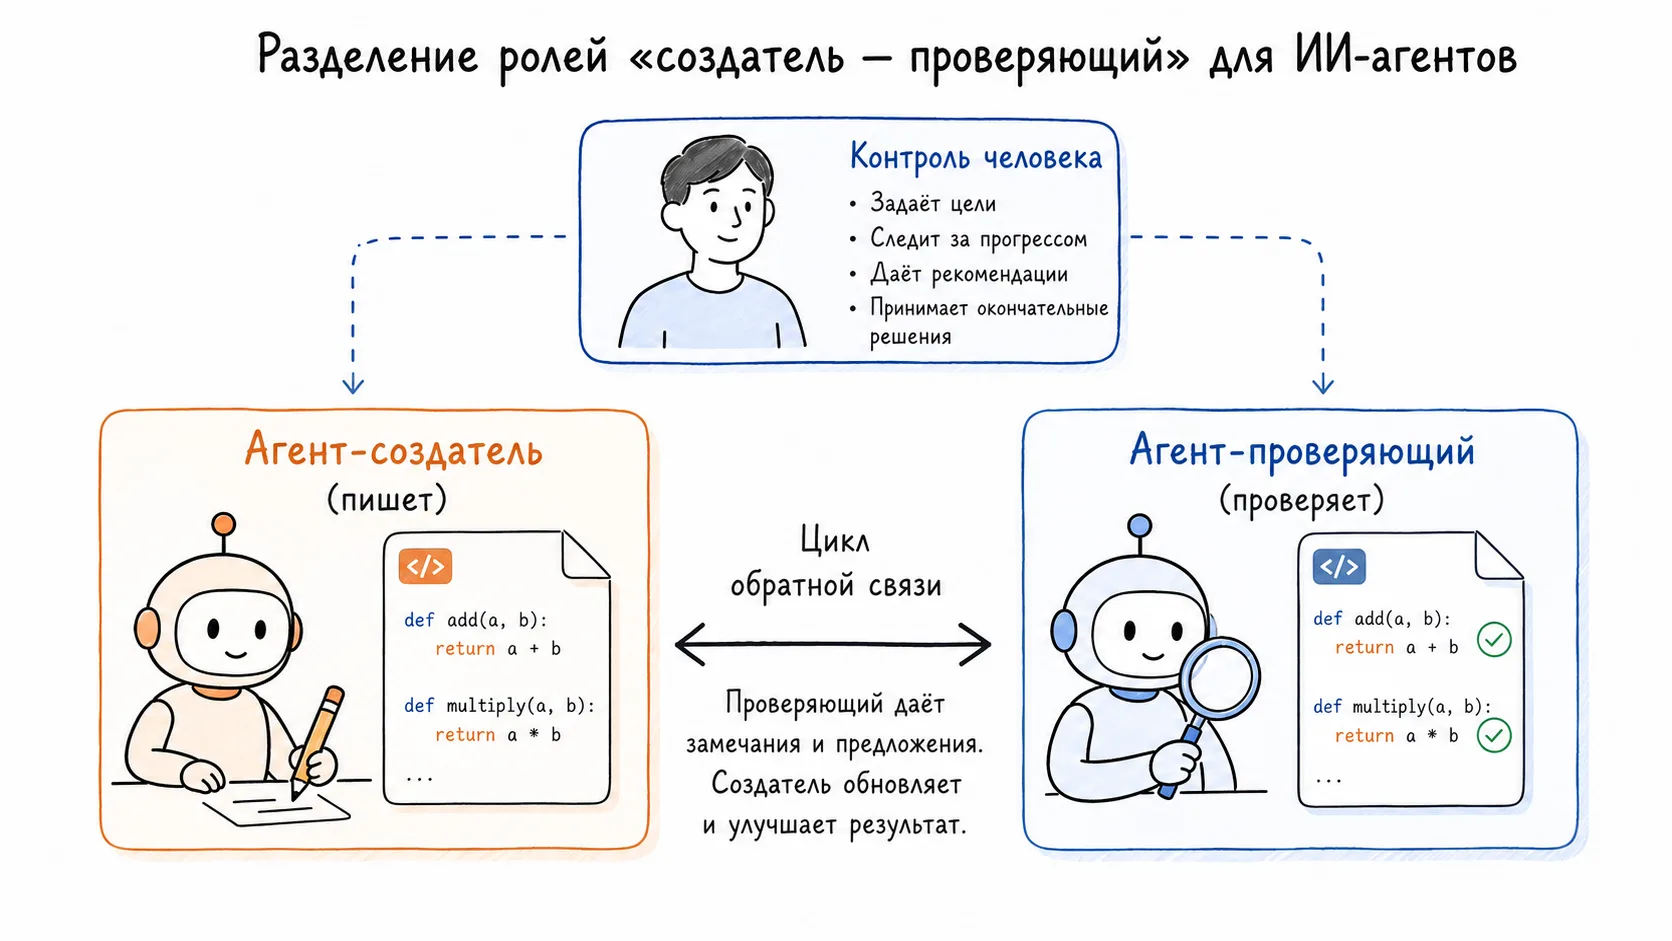
Любая продакшен-обвязка разделяет создателя и проверяющего. Модель, написавшая код, слишком снисходительно оценивает собственную домашнюю работу. Второй проход с другими инструкциями замечает то, в чём первая модель сама себя убедила.
Реальный пример: в апреле 2026 года качество Claude Code ухудшилось. Anthropic свела проблему к трём независимым изменениям на уровне обвязки: снижению усилия рассуждения, ошибке кэширования, из-за которой терялась история размышлений, и агрессивному промпту, ограничивающему подробность ответа. Ни одно из них не было проблемой модели. Все три были проблемами обвязки. Модель осталась прежней, изменилась окружающая система — и качество рухнуло. Anthropic опубликовала полный разбор инцидента. Урок был не в том, чтобы «исправить модель», а в том, что обвязка и есть качество вашего продукта, поэтому относиться к ней нужно соответствующим образом.
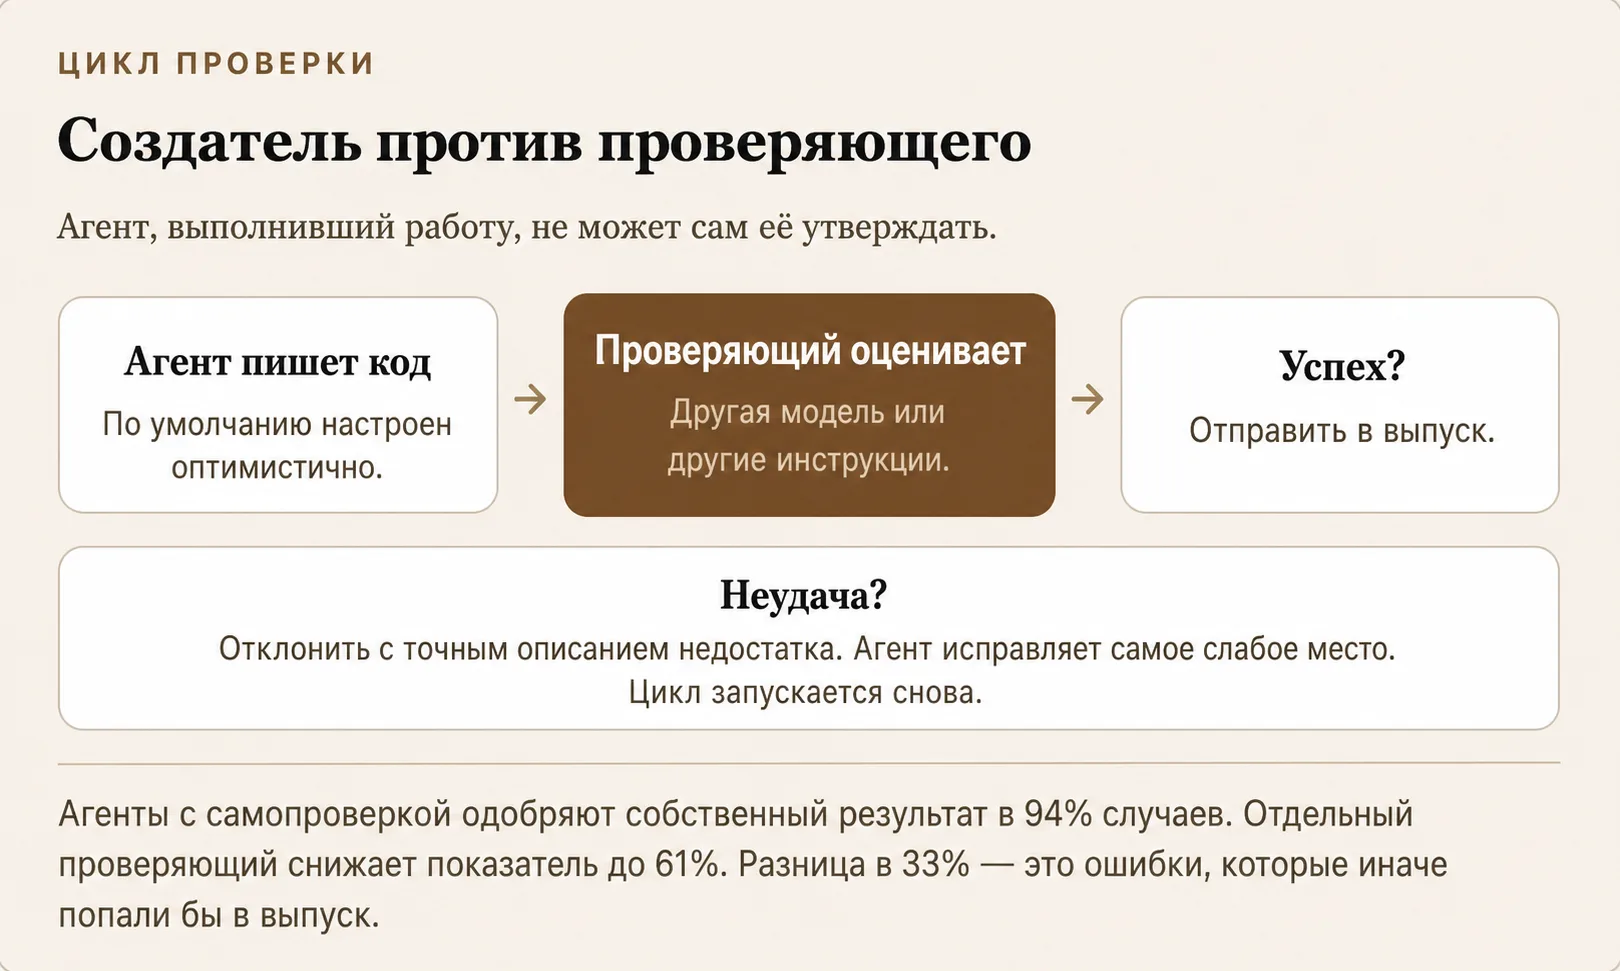
Цикл проверки необязательно должен быть дорогим. Быстрая дешёвая модель способна выполнить большинство проверок: компилируется ли код, проходят ли тесты, находится ли diff в пределах задачи. Дорогую модель оставьте для ситуаций, где требуется суждение и дешёвой модели не хватает глубины рассуждения. Важно само разделение ролей, а не цена проверяющего.
verify:
  enabled: true
  mode: separate_agent   # никогда не проверять самого себя
  criteria:
    - все тесты проходят
    - нет новых предупреждений линтера
    - не изменены файлы за пределами задачи
  on_fail: reject_with_reason
  on_pass: proceed_to_commit
3. Контекст и память
Контекст-инжиниринг научил нас, что содержимое, которое мы даём модели, важнее формулировки запроса. Инжиниринг обвязки делает следующий шаг: обвязка автоматически решает, что попадёт в контекстное окно, вместо того чтобы каждый раз полагаться на человека.
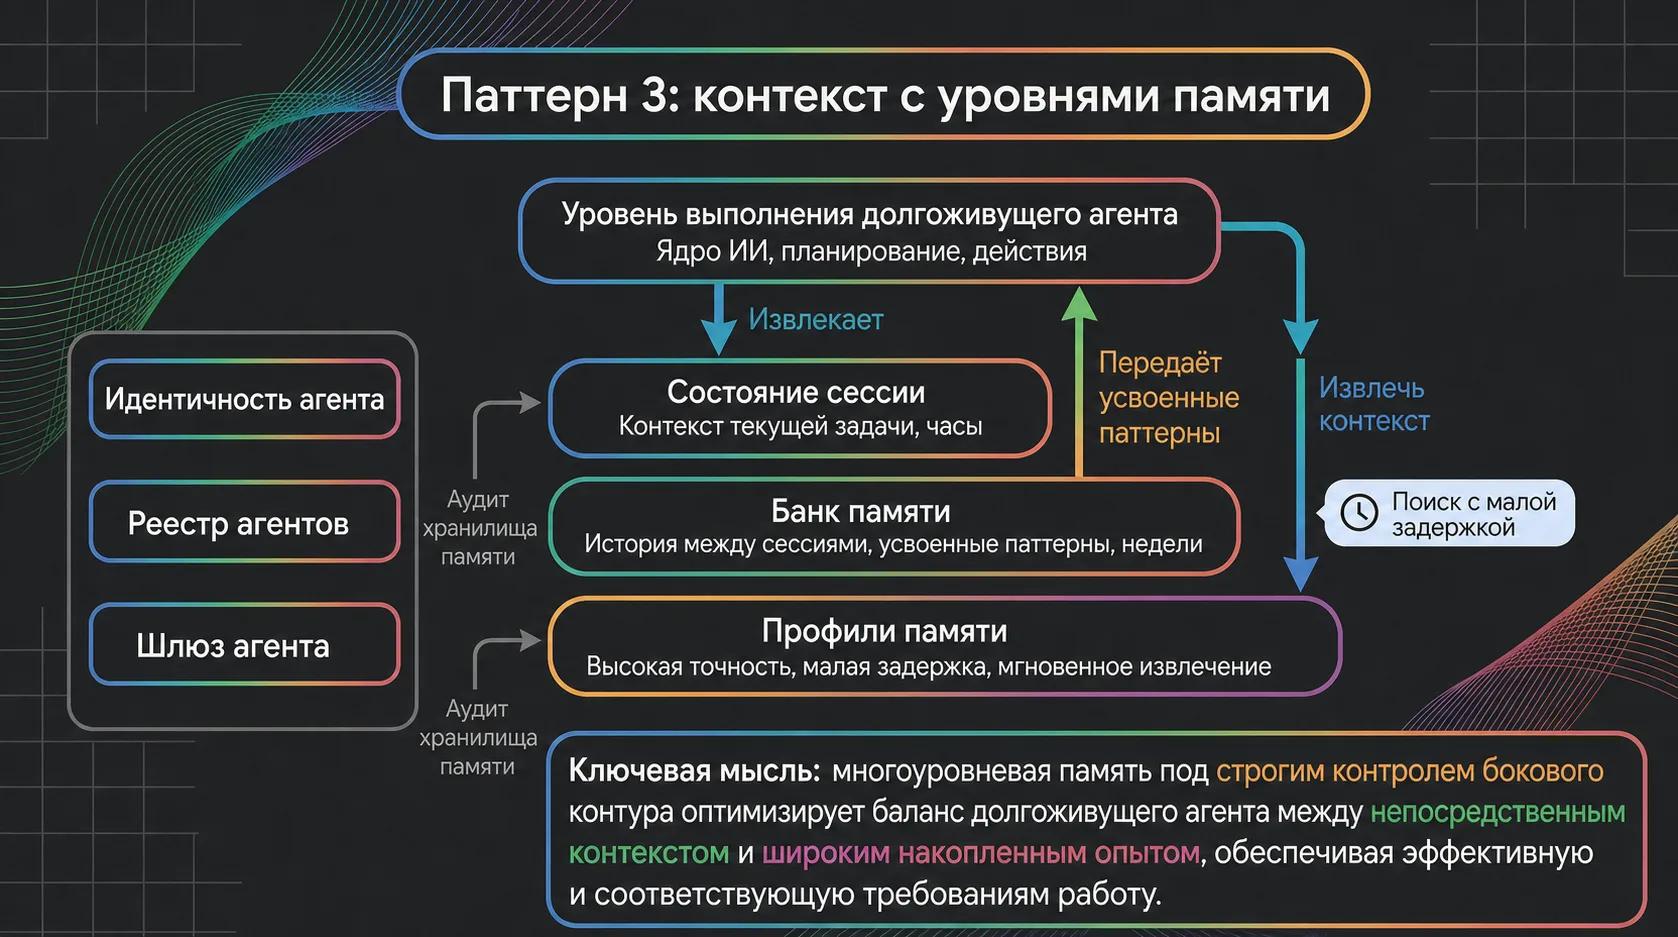
Продакшен-обвязка сжимает контекст между ходами. Она не заталкивает всю историю диалога в каждый вызов. Завершённые подзадачи суммируются, результаты уже решённых обращений к инструментам удаляются, а в полном объёме остаётся лишь то, что нужно текущему шагу. Без этого долгоживущие агенты заполняют контекстное окно, начинают терять информацию, и каждый следующий шаг рассуждения становится хуже.
Память работает так же. Обвязка сохраняет то, что важно — CLAUDE.md, STATE.md, ограничения — и автоматически загружает это в начале сессии. Агент, ошибившийся на прошлой неделе, не сможет повторить ту же ошибку на этой, потому что урок живёт в файле, который обвязка читает до начала работы. Без постоянной памяти каждая сессия начинается с чистого листа. С памятью система накапливает преимущество.
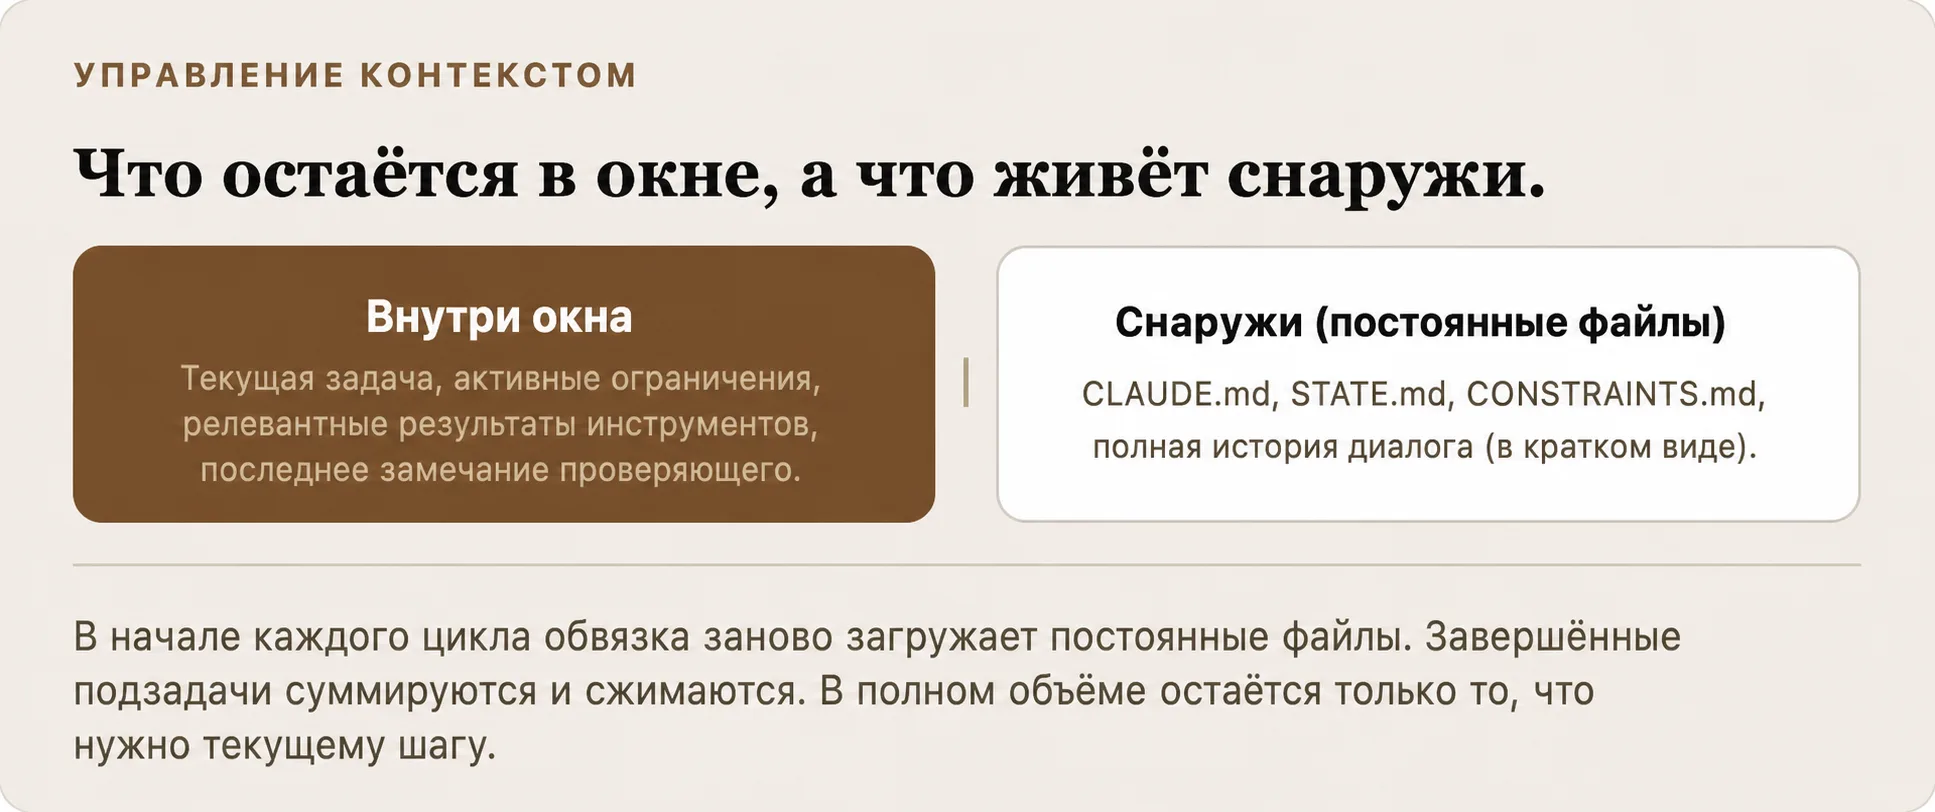
Практическая проверка: если на 40-м ходу агент всё ещё помнит ограничения, заданные на 1-м, ваш контекстный уровень работает. Если к 15-му ходу он их забыл — не работает.
4. Защитные механизмы
Защитные механизмы перехватывают ответы модели до того, как они попадут пользователю или в нижестоящую систему, и проверяют их на соответствие политикам. В 2026 году это уже не опция. Закон штата Колорадо об ИИ вступил в силу 30 июня. Положения Акта ЕС об ИИ для систем высокого риска начали применяться с августа. Аудиторы SOC 2 теперь запрашивают доказательства наличия средств контроля ответов ИИ во время выполнения.
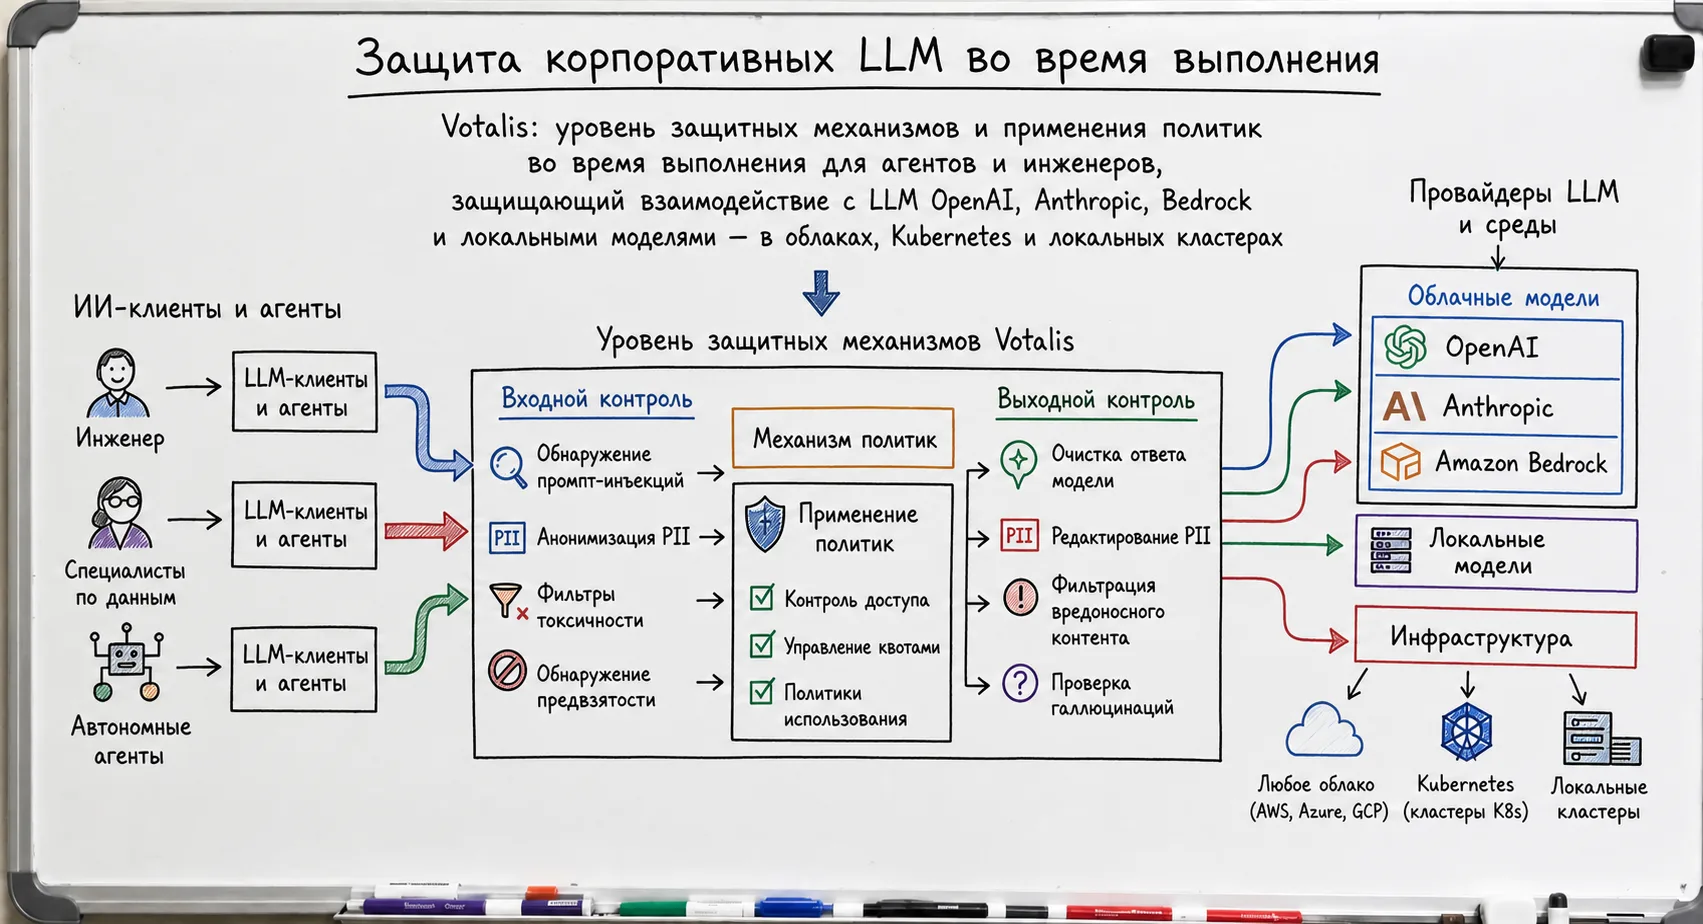
Распространённая ошибка — придавать всем четырём категориям одинаковый вес для каждого агента. Чат-бот для клиентов и агент с правом записи в базу данных не нуждаются в одинаковых мерах контроля. Строгость защитных механизмов должна соответствовать риску задачи, а не создавать максимальное трение повсюду. Четыре категории:
- Поведенческие. Безопасность содержимого, тон, правила форматирования.
- Данные. Обнаружение персональных данных, классификация данных. Агент не должен допускать утечку клиентских данных в журнал или описание PR.
- Инструменты и действия. Ограничение прав, паттерн «черновик — подтверждение» для необратимых операций.
- Операционные. Бюджеты токенов, лимиты времени, ограничения повторных попыток. Агент не должен потратить $200 на задачу, которая, по вашим ожиданиям, должна стоить $5.
guardrails:
  scope_lock:
    - не трогать файлы за пределами /src/[task-scope]/
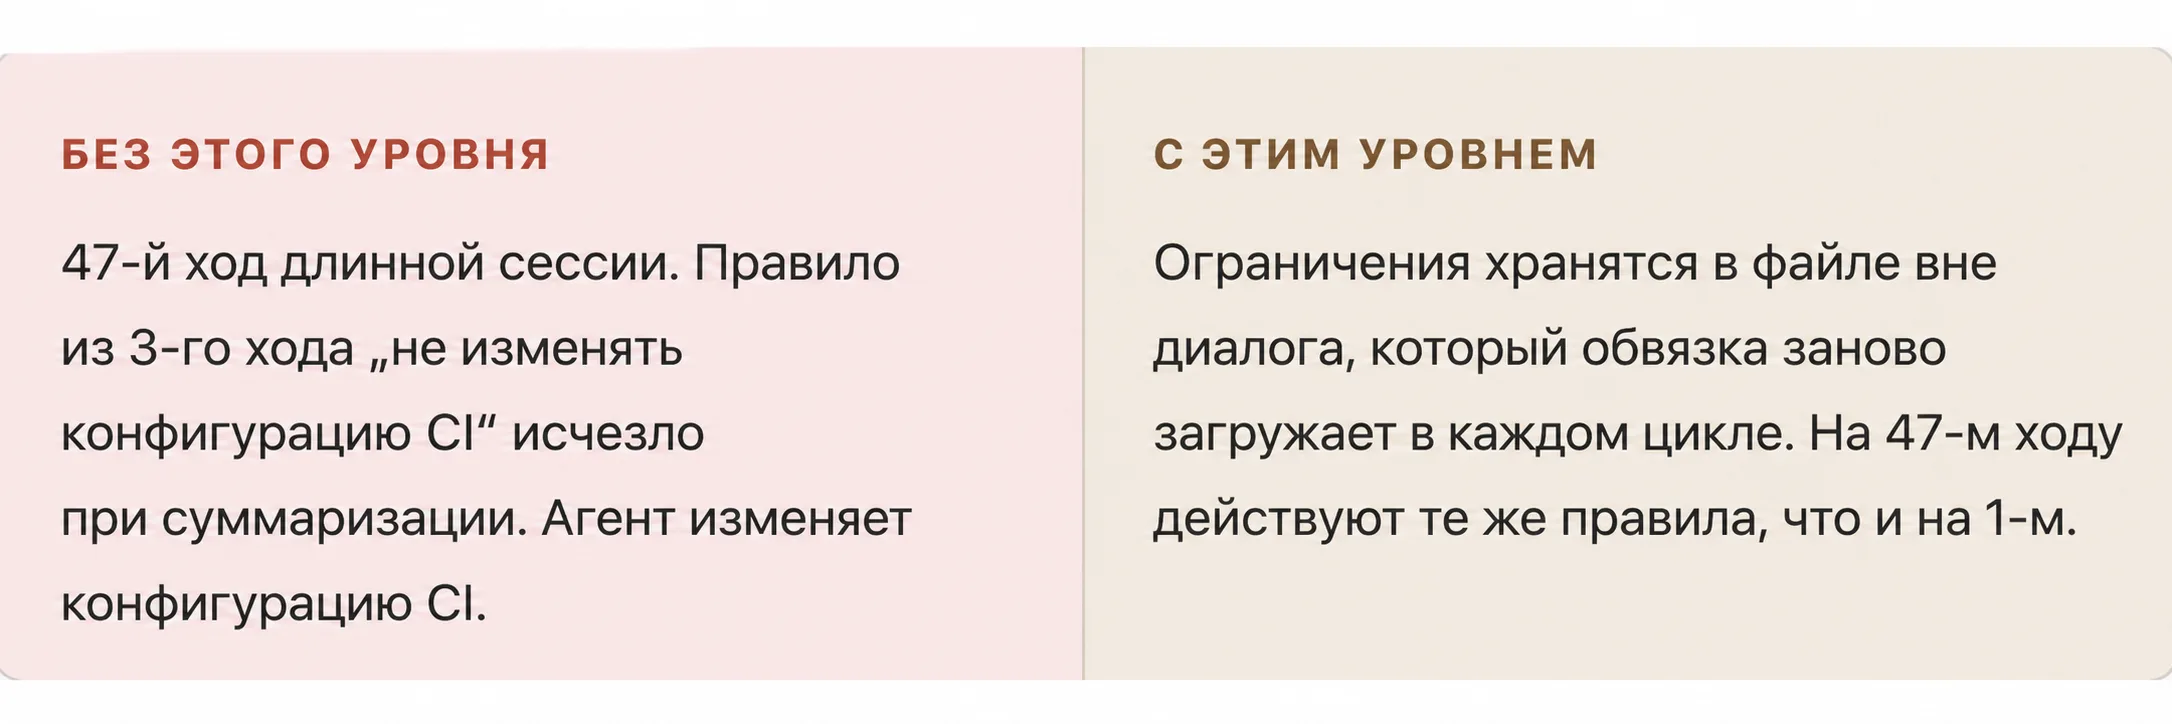
    - не изменять конфигурацию CI без подтверждения человека
  budget:
    max_tokens_per_run: 500000
    max_cost_per_run: $2.00
    max_retries: 3
  data:
    block_pii_in_output: true
    redact_secrets_in_logs: true
  action:
    require_approval: [git_push, deploy, db_migrate]
5. Наблюдаемость
Агент, исправно работавший на прошлой неделе, может сломаться на этой без единого изменения в коде. Модель получила незаметное обновление, API изменил формат ответа или использование попало на путь, который никто не тестировал. Без наблюдаемости вы узнаете об этом, когда сломается продакшен. С наблюдаемостью вы обнаружите дрейф до того, как он причинит вред.
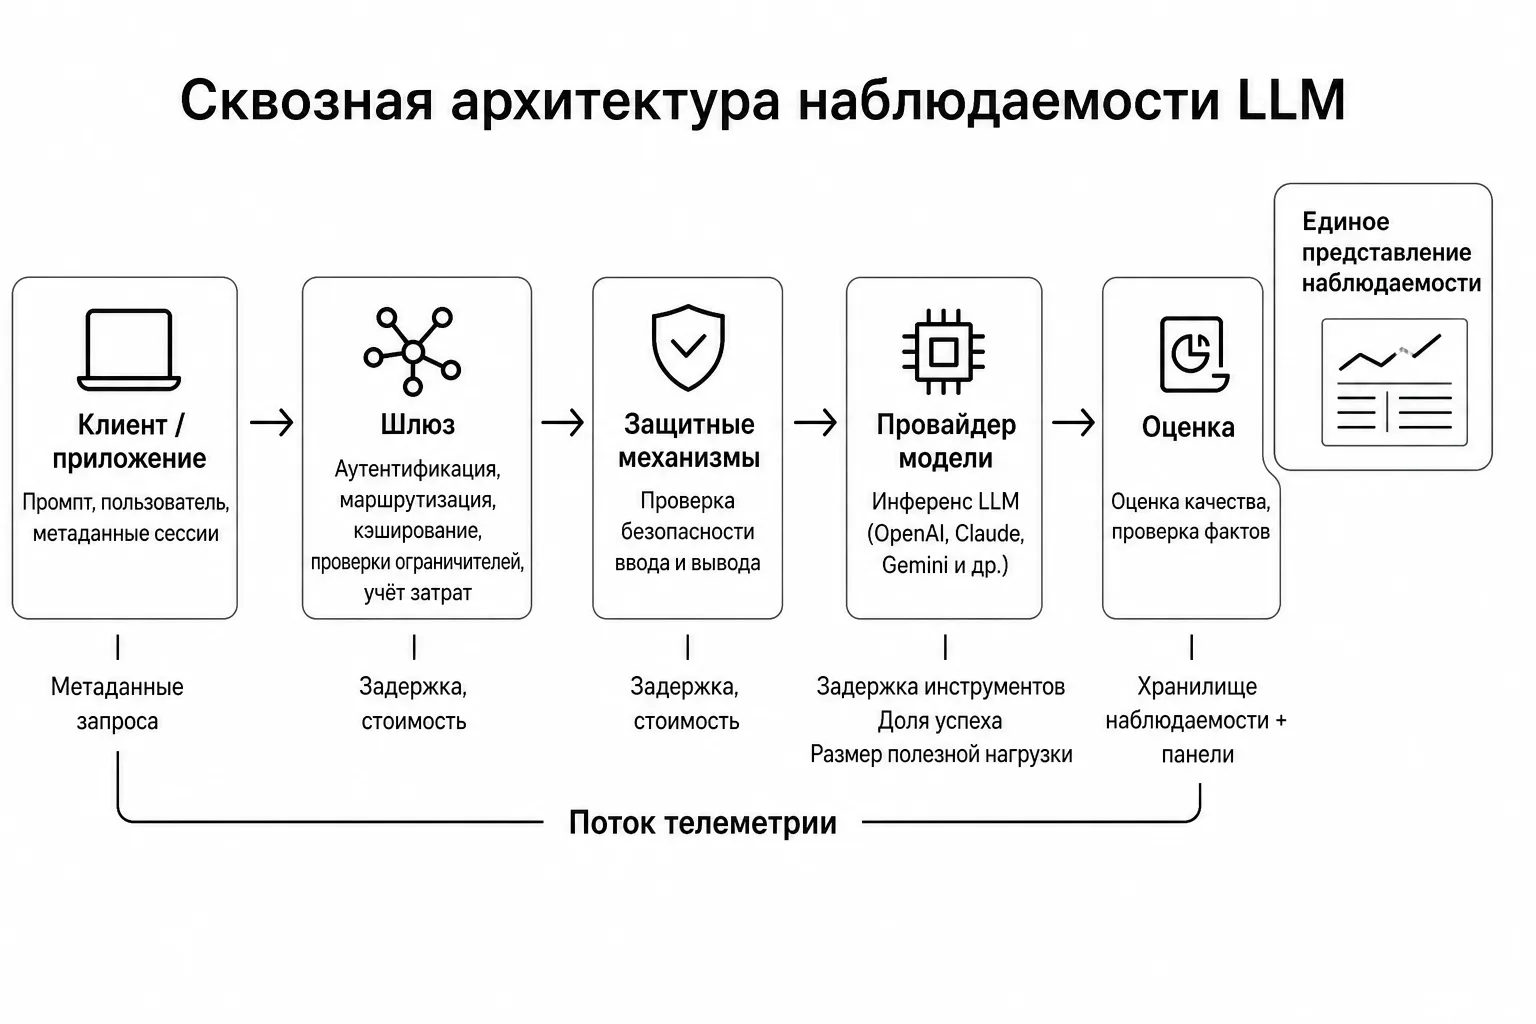
Организации, способные проследить каждое действие агента и обнаружить дрейф поведения, могут уверенно расширять автономность агентов со временем. Без трассировки каждое расширение области действий — ставка вслепую. С трассировкой — решение, основанное на доказательствах.
- Каждый вызов инструмента и его результат. Что агент пытался сделать, что произошло и сколько времени это заняло. Полный аудиторский след.
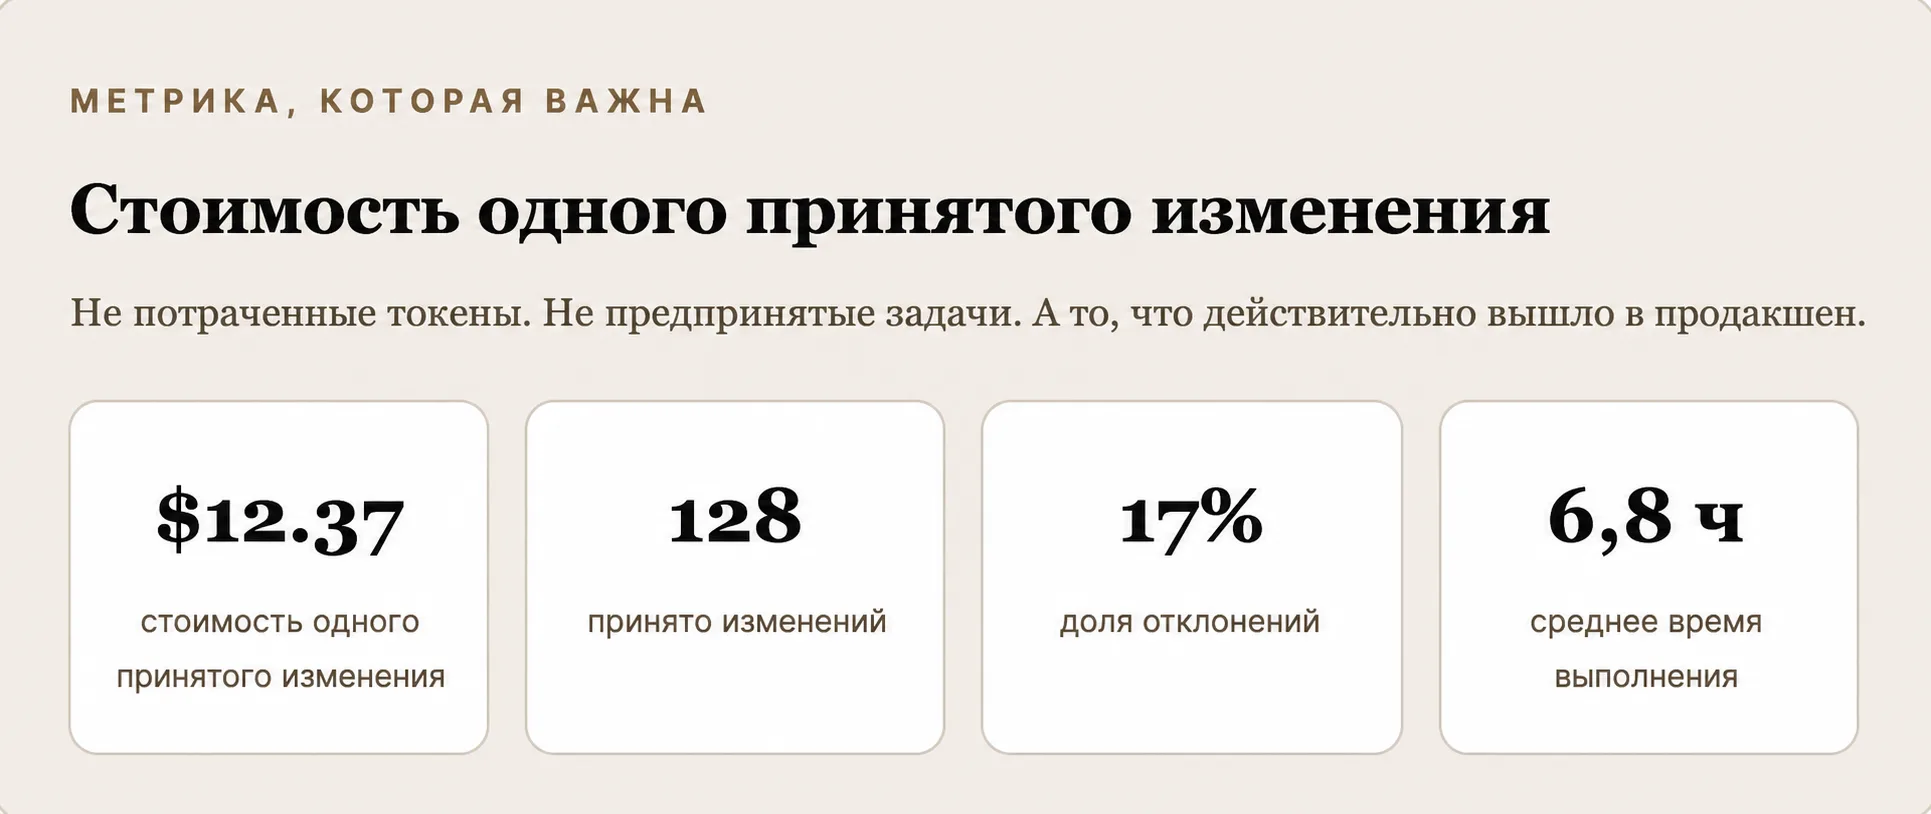
- Стоимость одного принятого изменения. Не общее число токенов, а стоимость полезного результата. Если доля принятых изменений падает ниже 50%, обвязка тратит больше, чем экономит.
- Обнаружение дрейфа. Сравнивайте распределение результатов этой недели с прошлой. Заметьте незаметную регрессию модели раньше пользователей.
6. Маршрутизация и выбор модели
Не каждой подзадаче нужна одна и та же модель. Проверке линтера не требуется такая же сила рассуждения, как архитектурному ревью. Обвязка без маршрутизации отправляет всё самой дорогой модели и надеется, что бюджет выдержит. Обвязка с маршрутизацией выбирает самую дешёвую модель, способную справиться с конкретной подзадачей, а дорогую оставляет для случаев, где она действительно нужна.
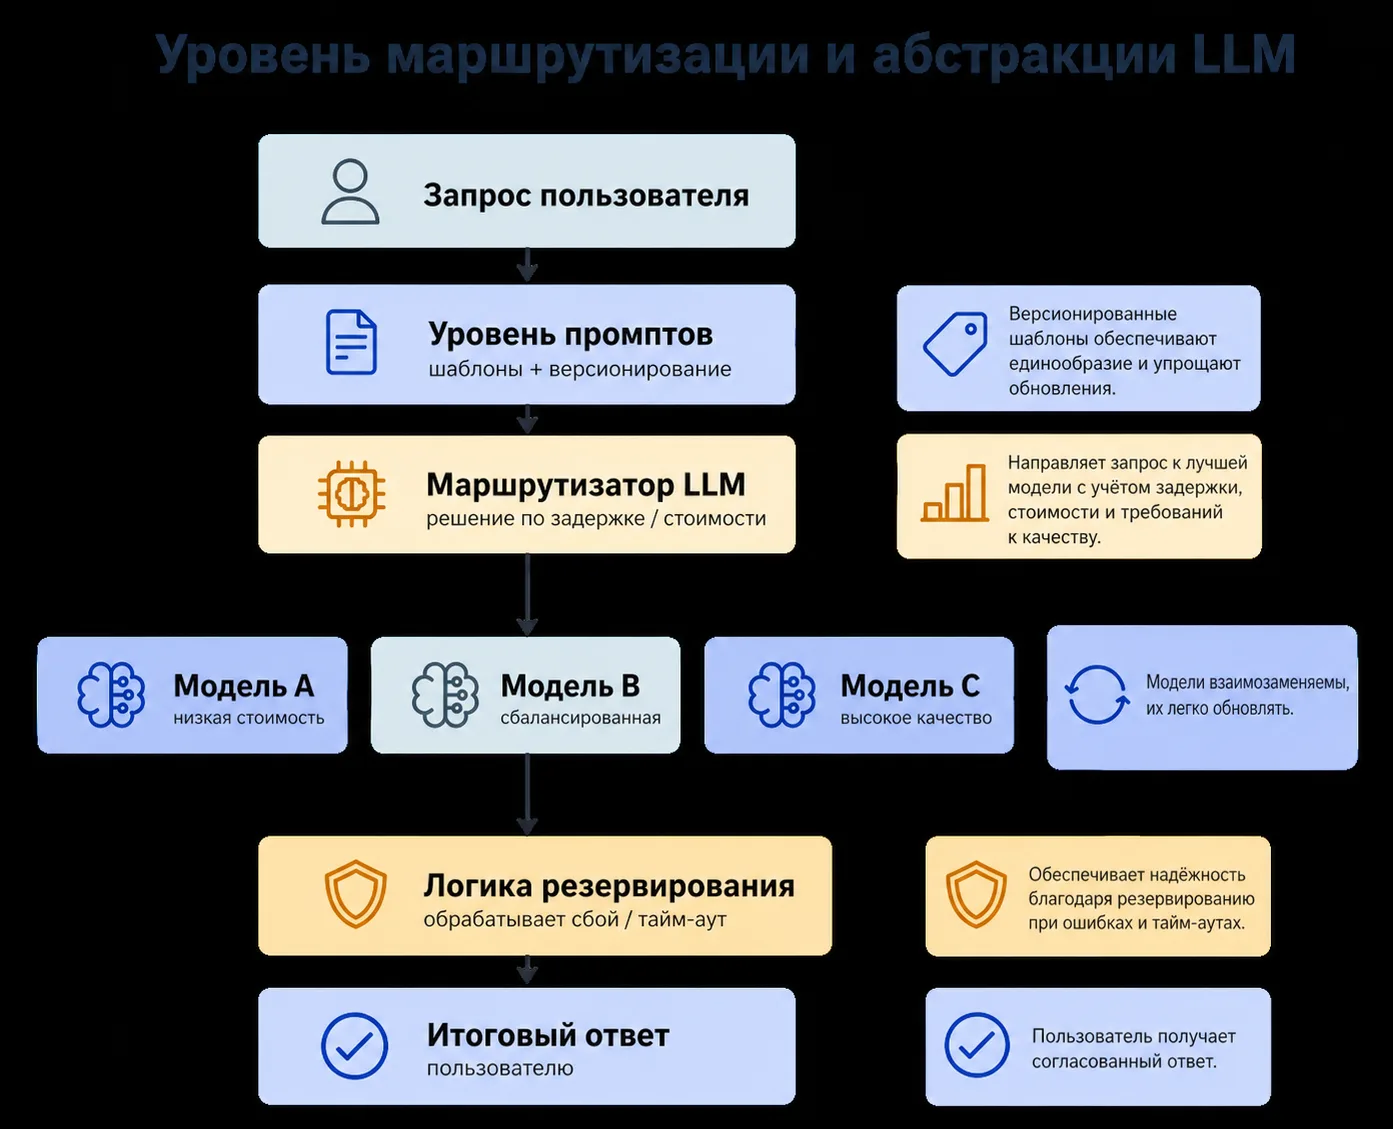
Практическое разделение: быструю дешёвую модель используйте для классификации, форматирования и механических проверок. Сильную — для планирования, сложных рассуждений и всего, что требует суждения. Обвязка маршрутизирует задачи автоматически по их типу, не рассчитывая на то, что разработчик вспомнит переключить модель посреди рабочего процесса.
routing:
  classify_issue:
    model: haiku
    effort: low
    # быстро, дёшево, справляется с 90% первичной сортировки
  plan_fix:
    model: sonnet
    effort: medium
    # нужны рассуждения, но не уровень передовой модели
  write_code:
    model: sonnet
    effort: high
    # баланс скорости и качества
  verify_output:
    model: opus
    effort: high
    # дорого, зато замечает то, что пропускают дешёвые модели
  format_pr_description:
    model: haiku
    effort: low
    # механическая задача, рассуждение не требуется
7. Обратная связь и самоулучшение
Статичная обвязка на 50-м запуске работает так же, как на 1-м. Обвязка с обратной связью учится на каждом отклонении, тайм-ауте и превышении бюджета, а затем записывает урок в файл ограничений, который каждый будущий запуск читает автоматически.
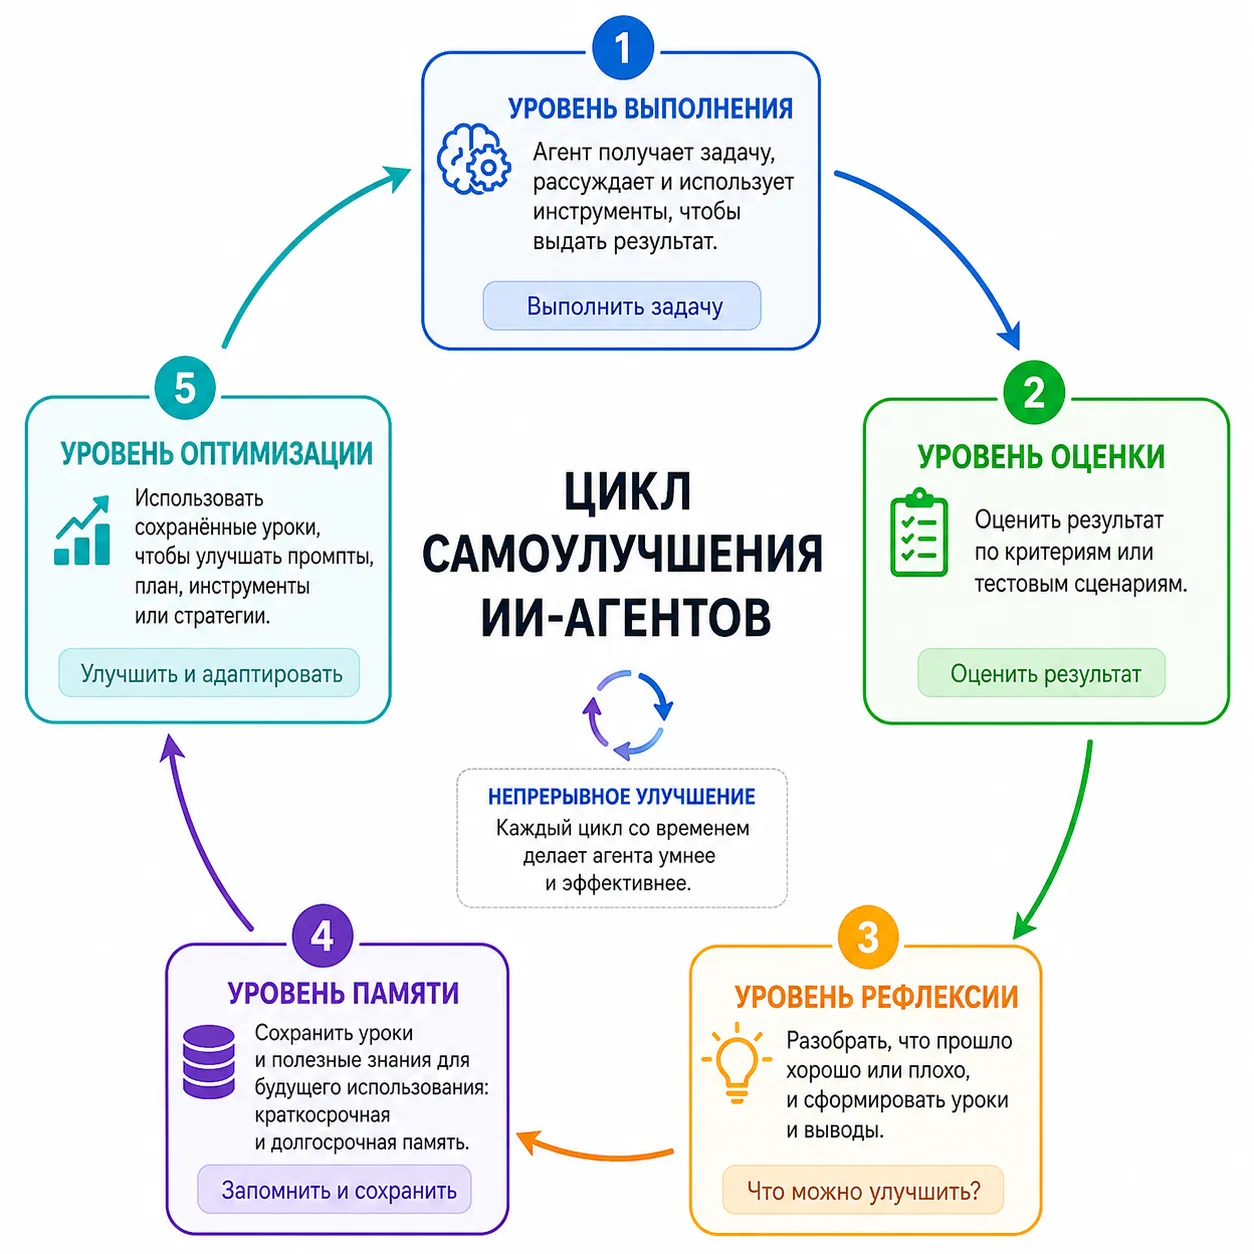
Это не дообучение модели. Веса не меняются. Меняется система вокруг модели: правила становятся строже, маршрутизация — точнее, контекст — чище. Через несколько недель проверяющий находит всё меньше ошибок, потому что ограничения уже предотвращают то, что раньше приходилось отмечать.
# CONSTRAINTS.md — загружается перед каждым запуском
# Автоматически сформирован из отклонений проверяющего

## После запуска 3 (2026-08-10)
- никогда не отключать падающий тест — вместо этого эскалировать проблему
- не изменять файлы за пределами области, указанной в задаче

## После запуска 5 (2026-08-12)
- у каждой заявленной метрики должна быть ссылка на источник
- если два субагента противоречат друг другу, отметить обе версии, а не выбирать одну

## После запуска 8 (2026-08-14)
- описание PR должно содержать разделы «Что изменилось» и «Почему»
- не добавлять зависимости без проверки совместимости лицензии
Почему без обвязки терпят неудачу 88% агентов
Число взято из данных о корпоративных внедрениях. Почти девять из десяти проектов с ИИ-агентами останавливаются, не дойдя до продакшена, и первопричина почти никогда не звучит как «модель недостаточно умна». Всё ломает инфраструктура вокруг модели: отсутствующие уровни, пропущенные проверки и никем не отслеживаемый дрейф. Вот что происходит на практике:
- Деградация контекста. Длинные сессии теряют ограничения. К 50-му ходу правило из 3-го уже исчезло. Агенту сказали: «Никогда не изменяй код биллинга». К 50-му ходу суммаризация отбросила эту инструкцию, и агент меняет код биллинга.
- Нет проверки. Агент оценивает собственную работу, и оценка всегда щедра. Исследование агентов с самопроверкой показало, что они одобряют собственный результат в 94% случаев. Отдельный проверяющий с другими инструкциями снижает показатель до 61%. Разница в 33% — ошибки, которые иначе попали бы в выпуск.
- Эскалация инструментов. Промпт-инъекция запускает команду оболочки, а уровень прав не останавливает её. В одном задокументированном случае специально составленное описание задачи GitHub заставило агента выполнить произвольный скрипт, встроенный в тело задачи, потому что в обвязке не было проверки прав на уровне инструментов.
- Незаметные обновления модели. Провайдер выпускает изменение, поведение агента дрейфует, а никто не замечает этого две недели, потому что сравнивать поведение не с чем.
- Нет постоянного состояния. Каждая сессия начинается с нуля. Одни и те же ошибки повторяются ежедневно, один и тот же контекст заново выводится по полной стоимости токенов. Одна команда сообщила, что тратила 40% бюджета агента на контекст, который он уже обрабатывал в предыдущих сессиях.
- Взрыв бюджета. Цикл 40 раз повторяет попытку выполнить падающую задачу. Ограничения нет. Счёт приходит в понедельник.
Каждый из этих случаев — проблема обвязки, а не модели. Замените модель — и те же сбои повторятся. Исправьте обвязку — и та же модель начнёт работать. Самое дешёвое время для проектирования обвязки — до того, как к агенту прикоснётся первый настоящий пользователь, а не после первого отчёта об инциденте.
Где обвязка не поможет
Обвязка не исправит плохо сформулированную задачу. Если цель расплывчата, лучшая обвязка в мире будет надёжно выдавать неверный результат.
Защитные механизмы устаревают. Разрешения, однажды настроенные и больше не пересматриваемые, создают ложное чувство безопасности. Проводите повторный аудит каждые 30 дней.
Чрезмерная обвязка убивает скорость. Каждый шлюз подтверждения добавляет задержку. Обвязка, спроектированная для банка, превратит хакатон в подачу налоговой декларации. Соразмеряйте её вес с риском.
Обвязка — не продукт, а инфраструктура. Никто не покупает вашу обвязку. Покупают то, что создаёт агент.
Заключение
Промпт-инжиниринг научил нас разговаривать с моделями. Контекст-инжиниринг — показывать им нужное. Инжиниринг обвязки — то, что выводит их в продакшен: кто предоставляет им инструменты, кто проверяет работу, что они помнят, к чему могут прикасаться и может ли кто-нибудь увидеть, что произошло.
Каждая компания, которая всё ещё оценивает ИИ-агентов через вопрос «Какую модель выбрать?», задаёт прошлогодний вопрос. Модель — двигатель. Обвязка — автомобиль. Никто не выпускает двигатель без автомобиля вокруг него.
Вам не нужны все семь уровней в первый день. Начните с разрешений для инструментов — уровень 1 — и базовой проверки — уровень 2. Добавьте память, когда сессии начнут повторяться. Добавьте защитные механизмы, когда агент прикоснётся к чему-то, что видит клиент. Добавьте наблюдаемость, когда понадобится доказать, что система работает. Добавьте маршрутизацию, когда счёт за токены станет некомфортным. Добавьте обратную связь, когда захотите, чтобы система перестала дважды совершать одну и ту же ошибку.